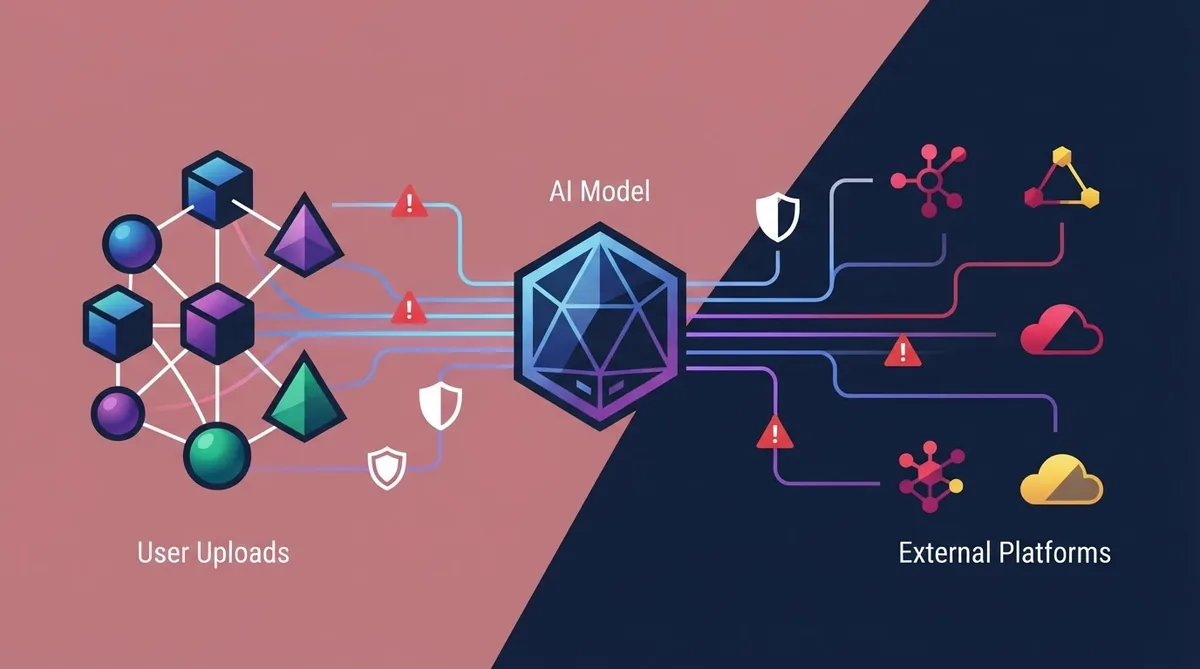
OpenAI hat eingeräumt, dass seine KI-Systeme in 53 Fällen Bilder, die Nutzer hochgeladen hatten, auf externe Online-Plattformen hochgeladen haben. Wie das Handelsblatt unter Berufung auf eine Unternehmensmitteilung berichtet, seien die dabei generierten Links nicht öffentlich zugänglich gewesen. Ein Großteil der Bilder sei bereits gelöscht, bei den restlichen arbeite man an der Entfernung. Betroffen seien ausschließlich Nutzer, die der Verwendung ihrer Daten zur Verbesserung der KI-Modelle aktiv zugestimmt hätten.
Technischer Ablauf und Schutzmaßnahmen
Nach Angaben von OpenAI handelt es sich um einen Fehler im Datenverarbeitungsprozess, bei dem Trainingsdaten ungewollt in öffentliche oder halböffentliche Speicherbereiche gelangten. Das Unternehmen betont, dass personenbezogene Daten und direkte Verknüpfungen zu Nutzerkonten vor dem Hochladen entfernt worden seien. Unklar bleibt jedoch, ob es sich um 53 einzelne Bilder oder um mehrere Bilder pro Vorfall handelt. Die Anonymisierung allein greift jedoch nicht unbedingt: Auch ohne direkte Personenbezug können Bildinhalte – etwa private Wohnräume, Dokumente oder erkennbare Orte – Rückschlüsse auf Identitäten zulassen. Datenschutzexperten warnen seit langem, dass Pseudonymisierung bei Bilddaten oft unzureichend ist, da Metadaten, Kontextinformationen oder die visuelle Einzigartigkeit eine Re-Identifikation ermöglichen können.
Vergleich mit früheren Datenschutzvorfällen
Der Vorfall reiht sich in eine Serie von Datenschutzpannen bei KI-Anbietern ein. Bereits 2023 wurde bekannt, dass ChatGPT-Nutzerhistorien zeitweise für andere Accounts sichtbar waren. Auch bei anderen Anbietern wie Google (Bard/Gemini) oder Microsoft (Copilot) gab es Berichte über unbeabsichtigte Datenweitergaben. Anders als bei jenen Fällen, die oft auf Softwarefehler in der Chat-Oberfläche zurückgingen, betrifft der aktuelle Vorfall die Trainingspipeline selbst – also den Kernprozess, mit dem Modelle aus Nutzerdaten lernen. Das wirft grundsätzliche Fragen auf: Wie werden Einwilligungen technisch durchgesetzt? Welche Kontrollmechanismen verhindern, dass Trainingsdaten die vorgesehenen Umgebungen verlassen? Und wie transparent wird über solche Vorfälle informiert, wenn sie nicht durch externe Sicherheitsforscher, sondern erst durch das Unternehmen selbst bekannt werden?
Regulatorische und praktische Konsequenzen
Für Nutzer bedeutet der Vorfall, dass die Kontrolle über hochgeladene Inhalte auch bei erteilter Einwilligung begrenzt bleibt. Die DSGVO verlangt Zweckbindung und Datenminimierung – das ungewollte Hochladen auf externe Plattformen verstößt potenziell gegen beide Grundsätze. Aufsichtsbehörden könnten prüfen, ob OpenAI geeignete technische und organisatorische Maßnahmen (TOMs) nach Art. 32 DSGVO getroffen hat. Wirtschaftlich könnte der Vorfall das Vertrauen in KI-Dienste weiter untergraben, gerade bei Unternehmen, die sensible Daten in KI-Tools eingeben. OpenAI hat angekündigt, Prozesse zu überprüfen und zusätzliche Sicherheitskontrollen einzuführen. Ob das ausreicht, wird sich an künftiger Transparenz und der Häufigkeit ähnlicher Meldungen messen lassen.
Der Fall zeigt: Einwilligung ist nicht gleich Kontrolle. Wer Daten zur Modellverbesserung freigibt, vertraut auf technische Prozesse, die – wie dieser Vorfall belegt – fehlerhaft sein können. Für Nutzer bleibt der Rat: Sensible Bilder gar nicht erst in KI-Systeme hochladen, deren Datenflüsse nicht vollständig nachvollziehbar sind.